

引言
这篇文章将介绍一种生成模型,VAE(变分自编码器),首先我们先理解一下有监督学习和无监督学习
一. 两种学习的区别
- 1. 有监督学习(Supervised Learning)
定义:训练数据同时包含输入特征 x 和对应的真实标签 y
核心思想:通过真实标签提供监督信号,使模型学习输入到目标输出的映射关系
目标:最小化预测值与真实标签之间的损失,提高模型在未知数据上的泛化能力
训练过程:输入数据 → 模型预测 → 计算损失 → 更新参数
典型任务:分类(Classification)、回归(Regression)
- 2. 无监督学习(Unsupervised Learning)
定义:训练数据不包含对应的目标标签 y,通常只提供输入数据 x
核心思想:从数据自身寻找隐藏的模式、结构、分布或有用的特征表示
目标:根据具体任务优化数据组织或表示,而非直接拟合外部提供的目标标签
训练过程:输入数据 → 根据任务目标进行处理或学习 → 优化结果
典型任务:聚类(Clustering)、降维(Dimensionality Reduction)、密度估计(Density Estimation)、表示学习(Representation Learning)
- 3. 两种学习方式的区别
a. 训练数据:有监督学习包含 (x,y);无监督学习通常只有 x
b. 学习目标:有监督学习侧重预测目标,无监督学习侧重发现数据本身的结构与规律
c. 训练依据:有监督学习利用标签计算损失;无监督学习利用不依赖外部目标标签的任务目标进行优化
d. 典型应用:有监督学习常用于图像分类、房价预测;无监督学习常用于数据分组、降维和探索数据分布
二. 生成模型
- 1. 目标
生成模型的统一目标都是通过给定训练集,产生与训练集同分布的新样本,希望学到一个模型pmodel(x),其与训练样本的分布 pdata(x)相近
- 2. 典型思路
这里介绍两种生成模型一般会用到的典型思路
a. 显式密度估计(Explicit Density Estimation)
- 核心思想:明确建立模型数据分布 ,通过训练使其接近真实数据分布。
- 特点:具有显式的概率模型,但不一定能够精确计算边缘概率密度。
- 代表模型:VAE、Autoregressive Model、Normalizing Flow。
b. 隐式密度估计(Implicit Density Estimation)
- 核心思想:不需要显式计算数据的概率密度,而是学习一个能够生成真实数据样本的模型。
- 特点:通常直接从随机变量生成数据,通过相应训练目标优化生成质量及分布匹配。
- 代表模型:GAN。
三. PixelCNN 和 PixelRNN
在正式介绍Vae之前,我们先了解同为显示密度估计的模型,PixelCNN 和 PixelRNN
他们利用概率链式法则,将联合概率分解为条件概率
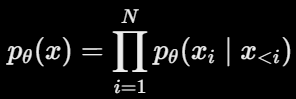
- 1. PixelRNN
a. 训练阶段:
主要采用循环序列的方式训练
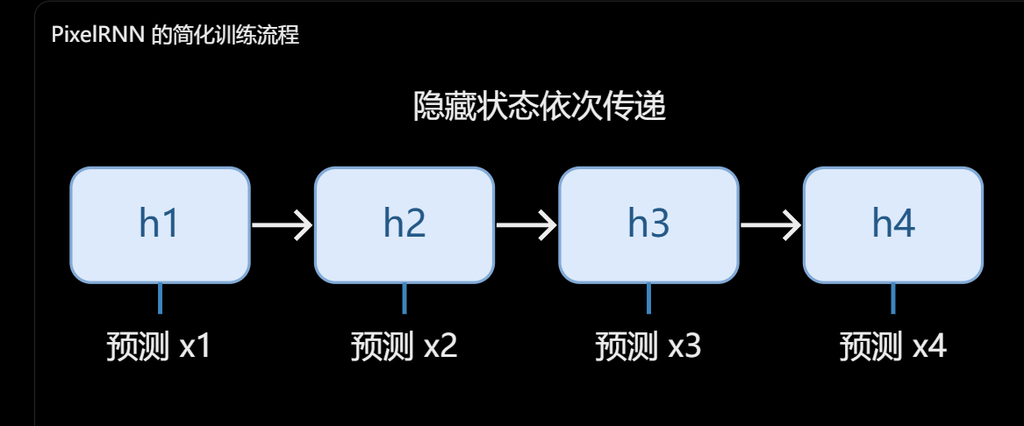
PixelRNN 主要利用循环网络建模像素之间的顺序依赖关系,通过隐藏状态传递先前像素的信息,预测当前像素的条件概率分布,随后利用真实像素值计算负对数似然损失(NLL),通过反向传播更新模型参数,如图所示:
b. 如何生成
PixelRNN 在生成阶段通过循环隐藏状态整合此前已生成像素的信息,预测下一个像素的条件概率分布,然后从该分布中采样像素值,不断重复直到生成完整图片
- 2. PixelCNN
a. 训练阶段
对比PixelRNN,PixelCNN的训练会更加快速,因为不再单纯的采用一维序列那样进行简单的循环遍历
PixelCNN 使用掩码卷积代替循环隐藏状态的更新,从而避免了大量必须顺序执行的循环计算
首先输入图片,提取当前像素之前允许访问的像素特征,再通过后续网络层预测当前像素的条件概率分布,同时因为掩码卷积提取的值是原始图片的像素点,因此可以进行并行计算预测,这是提升训练速度的关键,同样的最后再计算loss反向传播更新卷积核参数
这里解释一下为什么能够并行计算:
掩码卷积计算的流程如图:
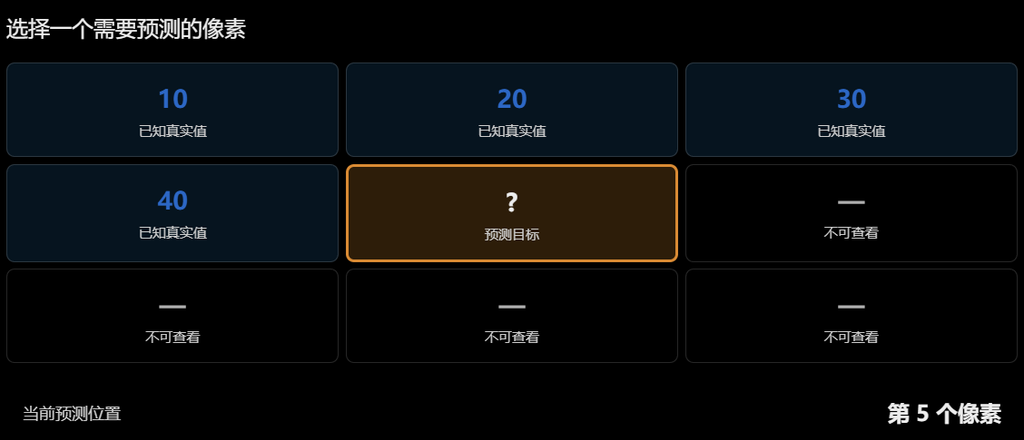
当预测第五个像素时,就看前四个原始图片的像素,再进行卷积核计算
因为预测使用的都是原始图片的像素,所以可以进行并行运算
b. 生成过程
PixelCNN 不依靠循环隐藏状态,而是通过掩码卷积,提取已生成像素的空间特征,然后预测下一个像素
- 3. 总结
PixelCNN 在训练阶段比 PixelRNN 更快,但是PixelCNN 和 PixelRNN在生成图片时都是通过逐步生成像素点的方式生成的,依旧很慢,而VAE 提供了另一种潜在变量生成方式
四. VAE
- 1. 简介
首先结合前面的知识,标准 VAE 通常属于无监督的显式概率生成模型
VAE 的全称是 Variational Autoencoder,中文名称是变分自编码器
因此在解释变分自编码器前,我们先讲解一下自编码器的内容
- 2. 自编码器
2.1 构成
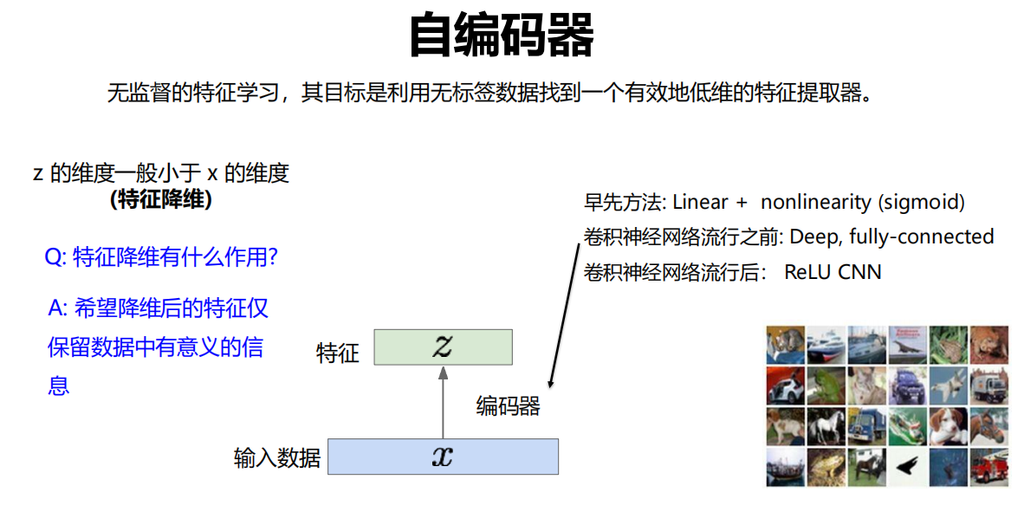
自编码器由 Encoder(编码器) 和 Decoder(解码器) 两部分组成的
Encoder:将输入数据编码为潜在特征表示 z,用于提取和压缩数据中的重要信息
Decoder:根据 Encoder 输出的潜在特征表示 z,重建原始输入数据,得到重建结果
2.2 是什么
无监督的特征学习,其目标是利用无标签数据找到一个有效(低维)的特征提取器
例如我们拥有大量的动物图片,我们可以通过学习得到编码器
编码器通常会学习如何组合、变换输入信息,以得到更紧凑的特征表示
例如可以将一个原来 784 维的数据表示成 32 维的特征向量
2.3 如何学习
假定我们的目标是得到一个可以提取动物特征的编码器
仅通过 Encoder 提取潜在特征 z,无法直接判断其是否保留了足够的原始数据信息
因此,在自编码器中引入 Decoder,根据 z 重建输入数据
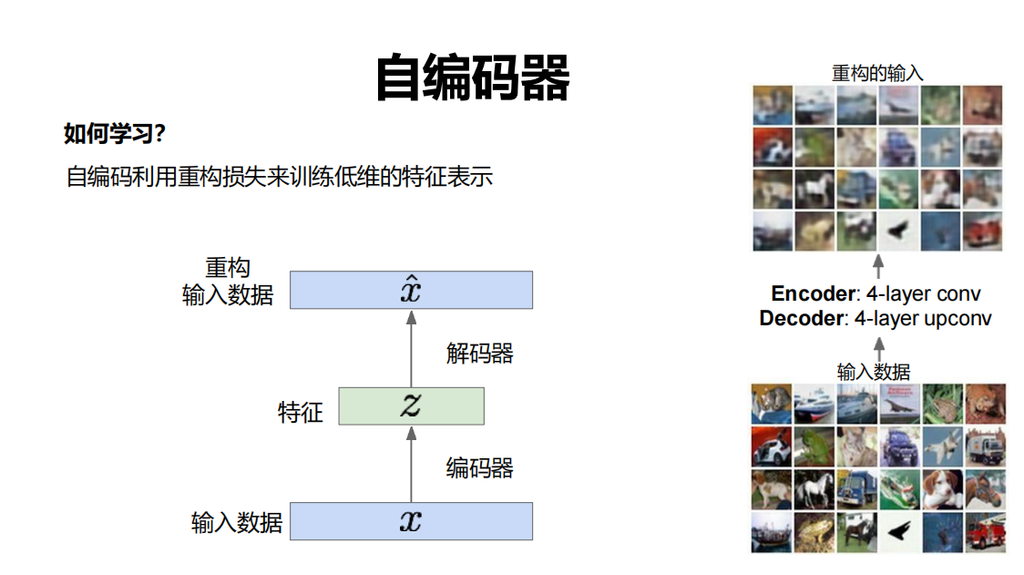
此时,我们将输入数据与重构数据进行计算L2损失,也就是两者的平方误差
再通过这个L2损失反向传播去更新 Encoder和Decoder 的可变参数,使得这个L2损失越小越好
2.4 得到结果
当我们通过不断的训练后就可以成功得到一个能够得出动物特征值的编码器Encoder
那我们可以用这个编码器干什么呢
还记得我在之前文章中讲过的分类模型吗,也就是Classification
我们可以将Encoder与此结合
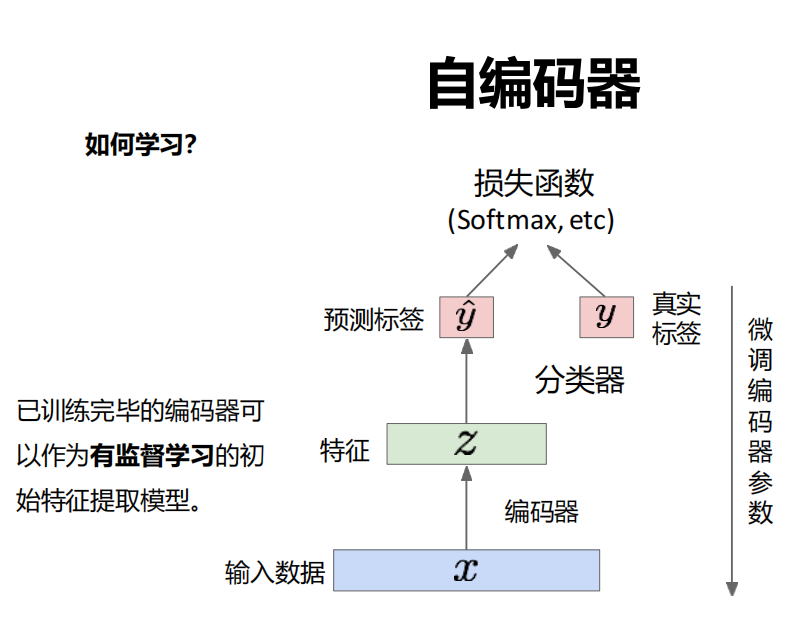
Encoder 提取输入数据的潜在特征 z ,Classifier(分类器) 根据特征预测类别 y,再将预测结果与真实标签 y 进行比较,计算分类损失,通过反向传播更新分类器参数,并可进一步微调 Encoder 参数
这就是无监督学习和有监督学习的结合
- 3. 为什么需要VAE
对于普通的自编码器(Autoencoder,AE)来说,其主要目标是通过 Encoder 提取输入数据的潜在特征,再利用 Decoder 尽可能准确地重建原始数据
但是,普通 AE 通常只通过重建损失进行训练,没有对潜在空间的概率分布施加明确的约束
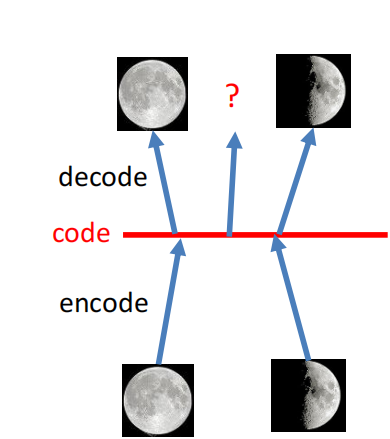
因此,虽然我们可以对两张图片对应的潜在向量进行插值,再通过 Decoder 生成中间图像,但无法保证插值区域能够生成自然、合理的图片
例如:
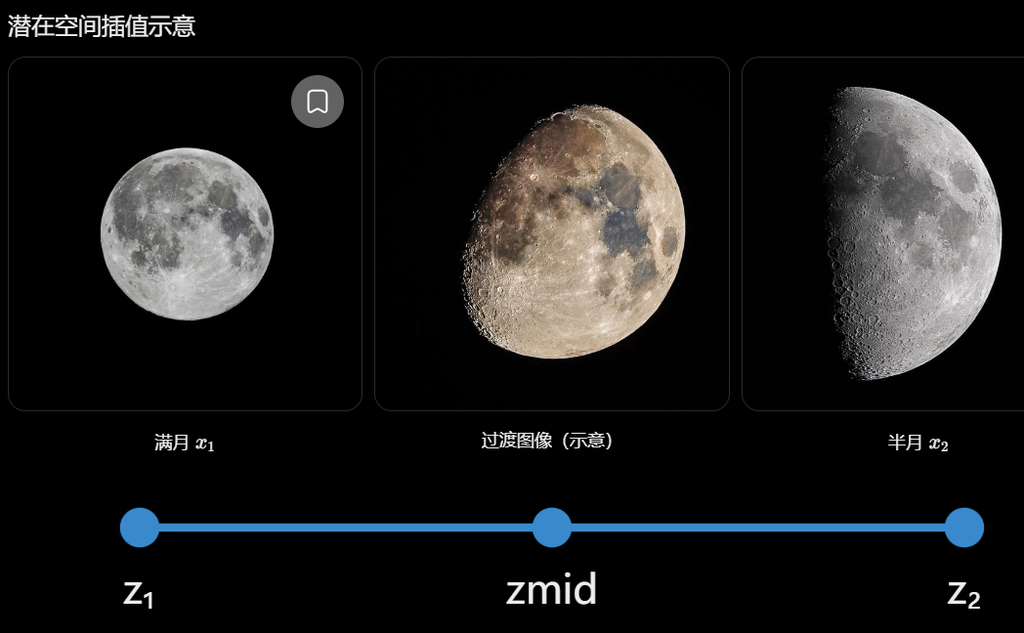
假设训练数据中存在一张满月图片和一张半月图片,我们希望生成一张介于两者之间的月亮图片。
普通 AE 可以对两张图片的潜在向量进行插值,但由于潜在空间缺乏分布约束,无法保证生成的中间图像符合真实数据的规律
而 VAE 相比普通 AE 的重要优势在于:不仅能够重建原始数据,还能够通过对潜在变量进行概率采样,实现新数据的生成
因此可以更好的实现在插值区域生成新图片
- 4. 为什么VAE可以做到
在解释为什么之前,我们先了解一下VAE的构造与普通的自编码器有什么区别
这里是VAE的构造图
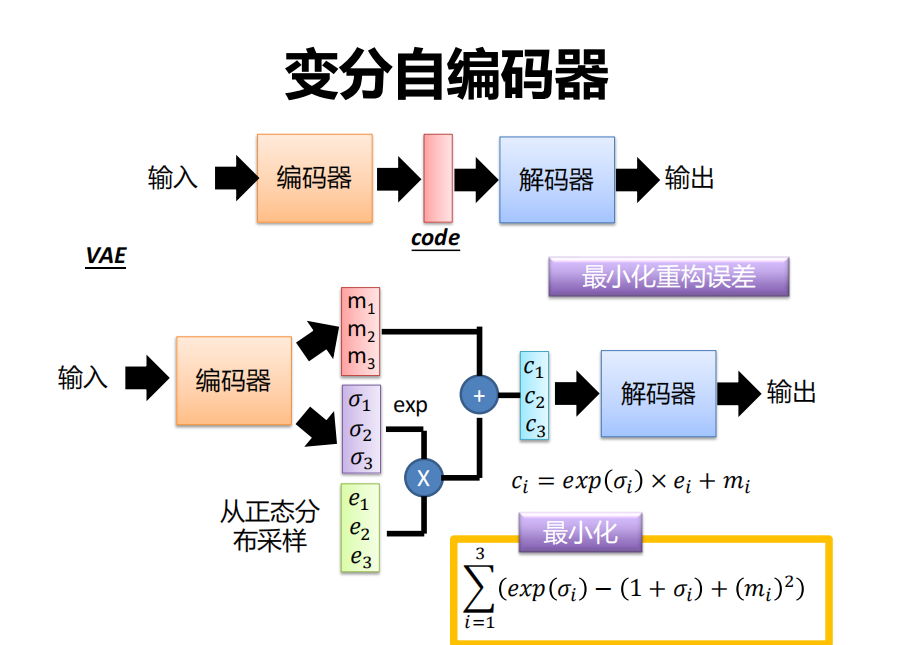
第一步:
输入一张图片,同样要通过Encoder,但是VAE的Encoder并不是直接输出特征向量z,而是输出均值和对数方差
例如将一张 28 * 28 的灰度图片展平为 784 维向量,而潜在空间的维度为3
那么 Encoder 的作用,就是根据这 784 个输入特征,预测一个三维高斯分布的参数
而输出均值和对数方差,可以理解为 Encoder 不再只指定潜在空间中的一个点,而是指定一个可以从中采样的概率分布
第二步:随机采样潜在变量 z
随机采样噪声,也就是图中的向量e,与标准差相乘再加上均值,就得到特征向量z
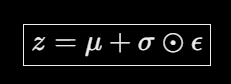
第三步:Decoder 根据 z 重建图片
- 那为什么可以做到普通的自编码器做不到的事呢?
通过流程分析我们可知,VAE 希望学习的是概率生成模型,而不仅仅是将每张图片编码成固定向量,因此加入了随机噪声,同时使用了概率建模、重建目标和 KL 散度约束,这样可以更好的生成随机图片
- 5. VAE如何训练
虽然随机噪声可以帮助VAE更好的学习概率生成模型,但是这是不够的,我们还要引入KL散度
5.1 第一步:重建损失
这一步与自编码器是相同的,VAE 需要衡量 Decoder 根据潜在变量 z 对原始输入数据的重建效果
但是VAE计算的方式有些许不同,重建项公式一般为
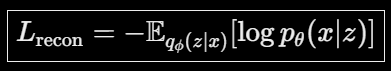
这一项主要是衡量 Decoder 能否根据 z 合理重建原图的损失
5.2 第二步:KL散度损失
这是与普通 AE 最主要的区别,如果只有重建项,那么 Encoder 生成的 z 只要能保证 Decoder 能够顺利生成响应图就可以了
但是 Encoder 产生的 z 就有可能极度分散,当我们随机采样 z 时,生成的图就会不尽人意
而KL散度就是为了让 Encoder 输出的分布不要偏离标准正态先验太多
这里是KL散度的计算公式:
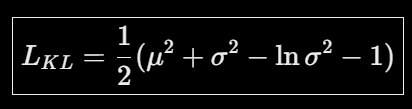
但是注意:VAE 并不是要让所有输入的潜在分布都完全变成标准正态分布
因为如果所有图片都编码成相同的分布,潜在变量就很难保留区分不同图片的信息
所以重建项与 KL 散度项需要共同发挥作用
5.3 第三步:把两种损失组合起来
现在我们就可以理解 VAE 的总损失:
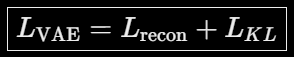
我们的目的是使这个总损失尽量小
重建损失和 KL 散度之间存在权衡关系
如果只强调重建质量,潜在分布可能偏离先验
如果过度强调 KL 散度,潜在变量可能失去部分输入信息,影响重建质量
5.4 第四步:反向传播更新参数
将损失传回 Encoder 和 Decoder,然后通过计算梯度更新 Encoder 和 Decoder 的参数
最后就可以得到合适的VAE
但是,Encoder 和 Decoder 接收的梯度来源并不完全相同
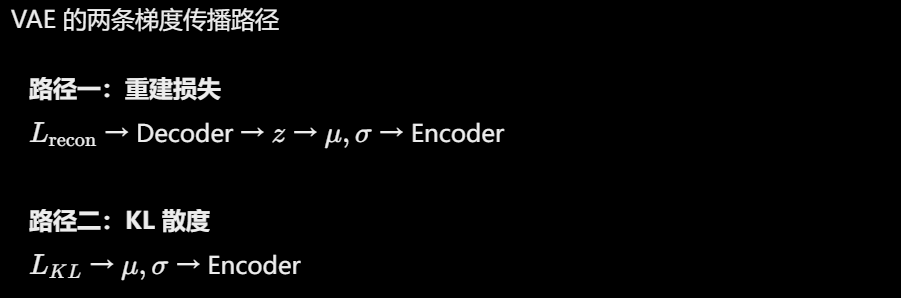
因此:
Decoder 的参数通常只受到重建损失的梯度影响
而 Encoder 的参数同时受到重建损失和 KL 散度损失的影响
- 6. VAE如何生成图片
与普通的 AE 生成图片其实是类似的,随机采样一个 z,然后输入给训练好的 Decoder,这样就可以成功生成图片了
总结
VAE的学习简直是有史以来最困难的一次,因为视频不太看得懂问了很多ai,到现在也没有太明白是如何通过反向传播更新参数的,但在学习过程中与之前的内容有一些联动了,还是有很大收获的吧
评论(0)
暂无评论