

引言
这篇文章将介绍关于神经网络的相关知识,包括神经网络的搭建,和一些神经网络操作
一. 神经网络的搭建
神经网络的搭建类似于创建一个类,但是与普通类不同的是,神经网络的搭建需要我们继承 nn.Module 这个类
继承完类之后再写__init__初始化函数和__forward__函数
其中__init__函数需要调用父类的继承方法,并且写一些关于神经网络的功能
而__forward__函数则是用于返回通过此神经网络后的值
这里给出一个简单的例子
from torch import nn


class Mzk(nn.Module):
    def __init__(self):
        super(Mzk, self).__init__()

    def forward(self, x):
        out = x + 1
        return out

mzk = Mzk()
x = 1
print(mzk(x))
这个神经网络的意思就是将输入值+1
二. 卷积操作
- 1. 含义
首先要了解什么叫做卷积操作
假设这里有一个3 * 3的数组作为卷积核,一个5 * 5的数组作为被卷积对象,我们现在对它进行卷积操作,就相当于把它们对应的数字相乘然后相加,这里给出一个视频举例
这里给出代码演示:
#卷积操作
input = torch.tensor([[1, 2, 0, 3, 1],
                      [0, 1, 2, 3, 1],
                      [1, 2, 1, 0, 0],
                      [5, 2, 3, 1, 1],
                      [2, 1, 0, 1, 1]])

kernel = torch.tensor([[1, 2, 1],
                       [0, 1, 0],
                       [2, 1, 0]])

input = torch.reshape(input, (1, 1, 5, 5))
kernel = torch.reshape(kernel, (1, 1, 3, 3))

convd = F.conv2d(input, kernel, stride = 1)

print(convd)
注意:因为 PyTorch 的 conv2d 要求输入数据和卷积核都是四维张量,而最初创建的是二维张量,所以要进行reshape操作
- 2. 卷积参数
卷积层分为很多种,最常用的是nn.Conv2d,所以在这里主要介绍关于nn.Conv2d的知识
首先我们先看它所有的参数
nn.Conv2d(
    in_channels,
    out_channels,
    kernel_size,
    stride=1,
    padding=0,
    dilation=1,
    groups=1,
    bias=True,
    padding_mode='zeros',
    device=None,
    dtype=None
)
可以看到它的参数是比较多的,但是对于新手而言,着重掌握前五个参数即可,后面的参数用处不大
a. in_channels 和 out_channels
这两个是必写的参数,代表写入数据的通道数和输出数据的通道数
b. kernel_size
这个表示卷积核的大小,如果写3就是3*3大小的卷积核
c. stride
这个代表卷积核每次移动的步长,例如上面视频演示的,步长就是1
d. padding
在输入边缘补充的像素值,如果卷积核走到边缘就没有值了,这时可以采用padding进行补值继续计算
- 3. 建立卷积网络
这里直接给出代码,搭建的方式与上文类似
class Mzk(nn.Module):
    def __init__(self):
        super(Mzk, self).__init__()
        self.conv = nn.Conv2d(in_channels = 3, out_channels = 3, kernel_size = 3, padding = 0)

    def forward(self, x):
        x = self.conv(x)
        return x
这里给出的双通道都是3,是因为图片一般都是三通道
- 4. 实例
这里给出实例代码,但也就是多了导入数据的数据,注意这里面的数据集是我提前下好了的,不要直接复制粘贴我的代码使用
import torch
import torch.nn.functional as F
from torch import nn
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
import torchvision

#卷积层操作
writer = SummaryWriter("logs")
transform_set = transforms.Compose([transforms.ToTensor(), transforms.Resize([32, 32])])

data_set = torchvision.datasets.ImageFolder(root = "data/train", transform = transform_set)

data_loader = torch.utils.data.DataLoader(dataset = data_set, batch_size = 64, shuffle = True, drop_last = True)

class Mzk(nn.Module):
    def __init__(self):
        super(Mzk, self).__init__()
        self.conv = nn.Conv2d(in_channels = 3, out_channels = 3, kernel_size = 3, padding = 0)

    def forward(self, x):
        x = self.conv(x)
        return x
mzk = Mzk()

step = 0
for data in data_loader:
    imgs, labels = data
    writer.add_images("input", imgs, step)
    output = mzk.forward(imgs)
    writer.add_images("output", output, step)
    step += 1

writer.close()
三. 最大池化
- 1. 含义
最大池化的意义是给定一个数列范围,在这个范围内寻找最大的像素值,取出作为输出值
同样的,假设这里有一个3 * 3的数组作为池化核,一个5 * 5的数组作为被池化对象,我们现在对它进行最大池化操作
- 2. 参数
最大池化最常用的是 nn.MaxPool2d,同样的我们来看一看它的参数
nn.MaxPool2d(
    kernel_size,
    stride=None,
    padding=0,
    dilation=1,
    return_indices=False,
    ceil_mode=False
)
我们可以发现这里的参数其实和 nn.Conv2d 是差不多的,这里我就解释一下没有解释过的参数
a. dilation
控制窗口采样位置的间隔,这里给出一个视频进行演示
b. ceil_mode
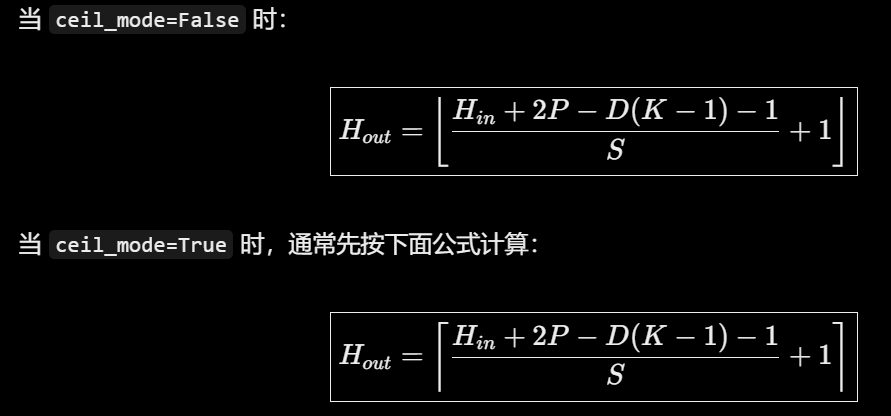
用于控制计算输出特征图尺寸时,是否采用向上取整的规则,例如如果是2.6,ceil_mode = Ture,那么输出的结果就会是3
- 3. 搭建最大池化网络
同样的,这里直接给出代码
class Mzk(nn.Module):
    def __init__(self):
        super(Mzk, self).__init__()
        self.maxpool = nn.MaxPool2d(kernel_size=3,  ceil_mode=False)

    def forward(self, x):
        output = self.maxpool(x)
return output- 4. 实例演示
from torch import nn
import torchvision.transforms as transforms
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter
from torchvision.datasets import ImageFolder

class Mzk(nn.Module):
    def __init__(self):
        super(Mzk, self).__init__()
        self.maxpool = nn.MaxPool2d(kernel_size=3,  ceil_mode=False)

    def forward(self, x):
        output = self.maxpool(x)
        return output
mzk = Mzk()

#导入数据
transform_set = transforms.Compose([transforms.ToTensor(),transforms.Resize([32, 32])])
#resize会影响池化结果

dataset = ImageFolder(root="./data/train", transform=transform_set)
dataloader = DataLoader(dataset=dataset, batch_size=64, shuffle=True, num_workers=0)

writer = SummaryWriter("maxpool2d")

step = 0
for data in dataloader:
    imgs, labels = data
    writer.add_images("input", imgs, step)
    output = mzk(imgs)
    writer.add_images("output", output, step)
    print(imgs.shape)
    print(output.shape)
    step += 1

writer.close()
四. 如何计算输出框架大小
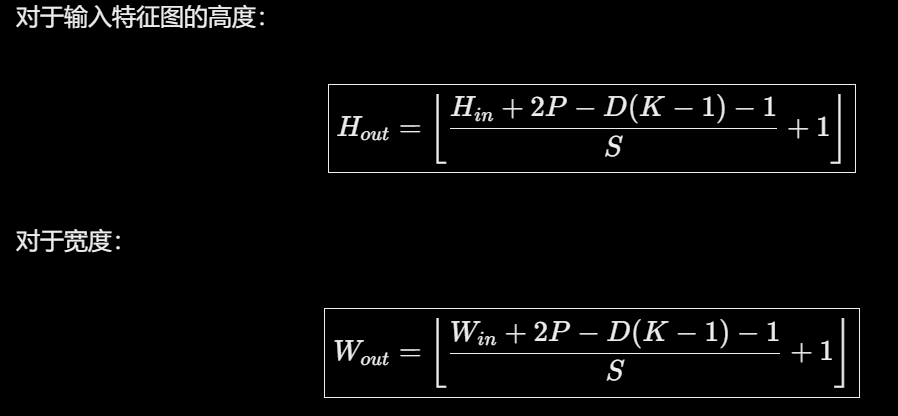
虽然输出的框架大小可以由计算机直接计算得到,但是有些时候也需要我们手动去进行计算,这里给出公式
- 1. 卷积层 nn.Conv2d 的输出尺寸公式
- 2. 最大池化层 nn.MaxPool2d 的输出尺寸公式
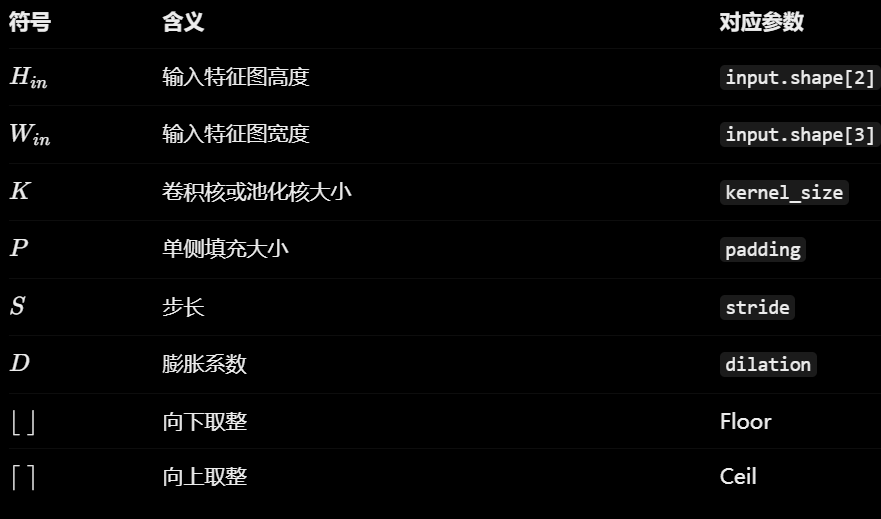
- 3. 各种符号的含义
- 4. 最常用的简化公式
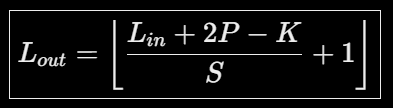
五. 非线性激活
这里介绍两个非线性激活的网络模型
- 1. ReuL
它的功能是 input 中小于0的截断输出0,大于0的正常输出
这里给出一个视频:
这里介绍关于 ReuL 仅有的一个参数:inplace
当赋值为False时,ReuL不会改变原变量
当赋值为True时,ReuL会改变原变量
例如:
#mzk是关于ReLU的一个网络

output = mzk(input)

#如果inplace = False
input不会改变
#如果inplace = True
input也会改变为经过RelU的结果- 2. sigmoid
作用是把每个输入数值压缩到 0~1 之间,同时给网络加入非线性
公式如下:
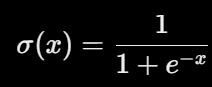
作用是使用方法与ReuL相同
- 3. 实例
这里给出使用非线性网络模型的代码
import torchvision
from torch import nn
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
import torch

#数据导入
transform_set = transforms.Compose([transforms.ToTensor(),transforms.Resize([32, 32])])
dataset1 = torchvision.datasets.ImageFolder(root='./data',transform= transform_set)
dataloader = torch.utils.data.DataLoader(dataset1,batch_size=64,shuffle=True,num_workers=0)

writer = SummaryWriter('logs')

class Net(nn.Module):
    def __init__(self):
        super(Net,self).__init__()
        self.relu1 = nn.ReLU()
        self.sigmoid1 = nn.Sigmoid()

    def forward(self,x):
        x = self.relu1(x)
        x = self.sigmoid1(x)
        return x

mzk = Net()

step = 0
for data in dataloader:
    imgs, labels = data
    writer.add_images("input", imgs, step)
    output = mzk(imgs)
    writer.add_images("output", output, step)
    step += 1

writer.close()
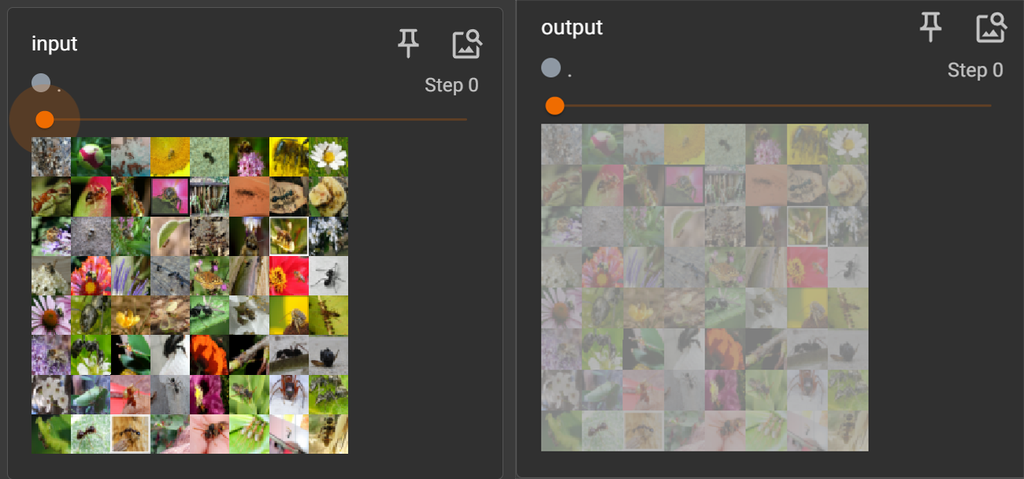
这里是进行处理后的结果(作为原图)
六. 线性层及其他层
这里给几个线性层的例子,具体使用方法与非线性层是几乎相同的,重点讲解一下 Linear 线性层
- BatchNormzd层
作用:每个通道的 batch 维度做归一化,把均值压回 0、方差压回 1,再用可学习的 γ、β 恢复表达能力
使用场景:CNN 图像分类
- Recurrent层
作用:逐时间步处理序列,靠隐藏状态 h 把上一步的信息传给下一步,因此天然建模时序依赖
使用场景:视频动作识别、逐帧文本识别
- Transformer层
作用:用自注意力让序列中任意两个位置直接建立联系,再用前馈网络做非线性变换,天然并行、适合长程依赖
使用场景:NLP 任务的事实标准:BERT、GPT 类的编码/解码骨干,处理长文本依赖
- Dropout层
作用:训练时按概率 p 随机把一部分神经元置零,强迫网络不依赖某几个特定神经元,相当于一种正则化,能缓解过拟合
使用场景:训练集较小、模型容量偏大时,防止过拟合
- Linear层
作用:把输入的通道数(或特征维度)映射到指定的输出维度,本身不含非线性表达能力
使用场景:几乎所有神经网络的末端输出层(分类、回归)和特征提取层(MLP、Transformer 的 FFN、卷积网络的 1×1 卷积等价形式),用于升维、降维和维度对齐
它的参数包含两个,第一个为输入通道,第二个为输出通道
这里给出一个使用的例子:
import torch
import torchvision
from torch import nn
from torch.nn import Linear, Flatten
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

dataset = torchvision.datasets.CIFAR10(
    root=r"D:\pytorch练习\data",
    train=False,
    transform=torchvision.transforms.ToTensor(),
    download=False
)

dataloader = DataLoader(dataset, batch_size=64, shuffle=False, num_workers=0)


class Mzk(nn.Module):
    def __init__(self):
        super(Mzk, self).__init__()
        self.linear1 = Linear(196608, 10)

    def forward(self, x):
        x = self.linear1(x)
        return x
mzk = Mzk()

writer = SummaryWriter("linear")

step = 0

for data in dataloader:
    imgs, labels = data
    writer.add_images("imgs", imgs, step)
    print(imgs.shape)
    output = torch.flatten(imgs)
    print(output.shape)
    output = mzk(output)
    print(output.shape)
    step += 1

writer.close()
这里相当于把 CIFAR10 这个数据集的图片展平后再进行线性变化,这样可以更全面的提取特征值
七. 实战
- 1. CIFAR10 的分类 model
这里写一个关于 CIFAR10 的分类 model,这里是结构图:
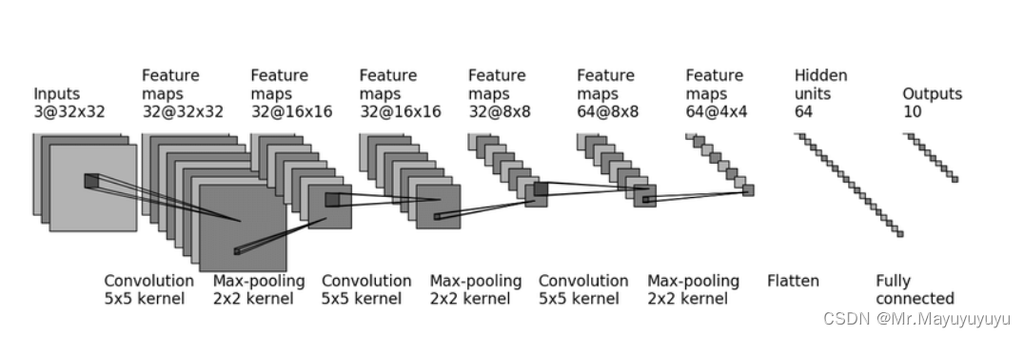
而我们的目标就是搭建这样的一个神经网络,其实并不难,只需要根据图中给定的参数,注意输入输出的通道数就可以成功搭建了,这里是搭建出的神经网络代码:
class MZK(nn.Module):
    def __init__(self):
        super(MZK, self).__init__()

        super().__init__(*args, **kwargs)
        conv1 = Conv2d(3, 32, 5, padding=2),
        maxpool1 = (MaxPool2d(2),)
        conv2 = Conv2d(32, 32, 5, padding=2),
        maxpool2 = MaxPool2d(2),
        conv3 = Conv2d(32, 64, 5, padding=2),
        maxpool3 = MaxPool2d(2),
        flaten = Flatten(),
        linear1 = Linear(64 * 64 * 4, 64),
        linear2 = Linear(64, 10)


    def forward(self, x):
        out = self.conv1(x)
        out = self.maxpool1(out)
        out = self.conv2(out)
        out = self.maxpool2(out)
        out = self.conv3(out)
        out = self.flaten(out)
        out = self.linear1(out)
        out = self.linear2(out)
        return out
这里举第一个网络结构作为例子讲解:
第一个卷积层,要求输入的图片为 3*32*32,而输出位 32*32*32,卷积核大小为 5*5
因此第一个参数输入通道数为3,第二个参数输出通道为32,第三个参数卷积核大小为5
因为输出的图片尺寸为 32*32,通过上述的长宽计算公式计算可知,padding要为2
这样就完成了第一个卷积层结构的搭建,后面的搭建也相似
- 2. Sequential用法
上述的神经网络看起来是十分的冗杂的,例如每一个网络结构都要创造一个变量,那有什么方法可以解决吗
只要利用 Sequential 就可以将这些网络结构整理在一起,类似于 transforms 中的 Compose
使用方法也很简单,参数就是这些网络结构,用逗号分隔开就可以了,例子如下:
class MZK(nn.Module):
    def __init__(self):
        super(MZK, self).__init__()
        self.model1 = Sequential(
            Conv2d(3, 32, 5, padding=2),
            MaxPool2d(2),
            Conv2d(32, 32, 5, padding=2),
            MaxPool2d(2),
            Conv2d(32, 64, 5, padding=2),
            MaxPool2d(2),
            Flatten(),
            Linear(1024, 64),
            Linear(64, 10)
        )

    def forward(self, x):
        x = self.model1(x)
return x- 3. writer.add_graph
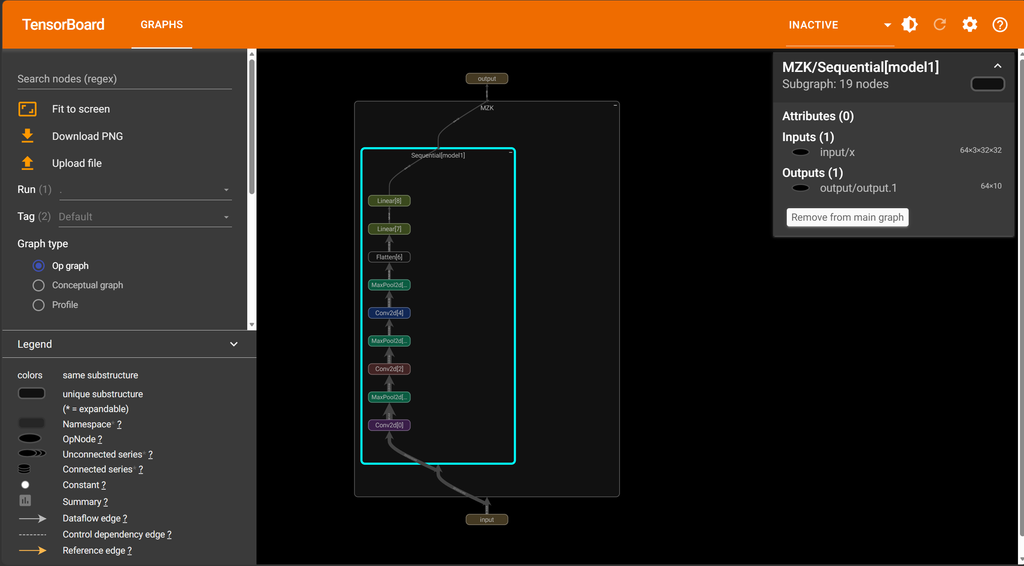
如果你想在 tensorboard 上更直观观看网络模型的架构,可以使用 writer.add_graph
writer.add_grap 的第一个参数为网络模型,第二个参数为能够跑通对应网络模型的数据
这里利用我们在上面写的 CIFAR10 的分类model 作为例子查看
mzk = MZK()
print(mzk)
input = torch.ones((64, 3, 32, 32))
output = mzk(input)
print(output.shape)

writer = SummaryWriter("./logs_seq")
writer.add_graph(mzk, input)
writer.close()
打开 tensorboard 后呈现的是这样
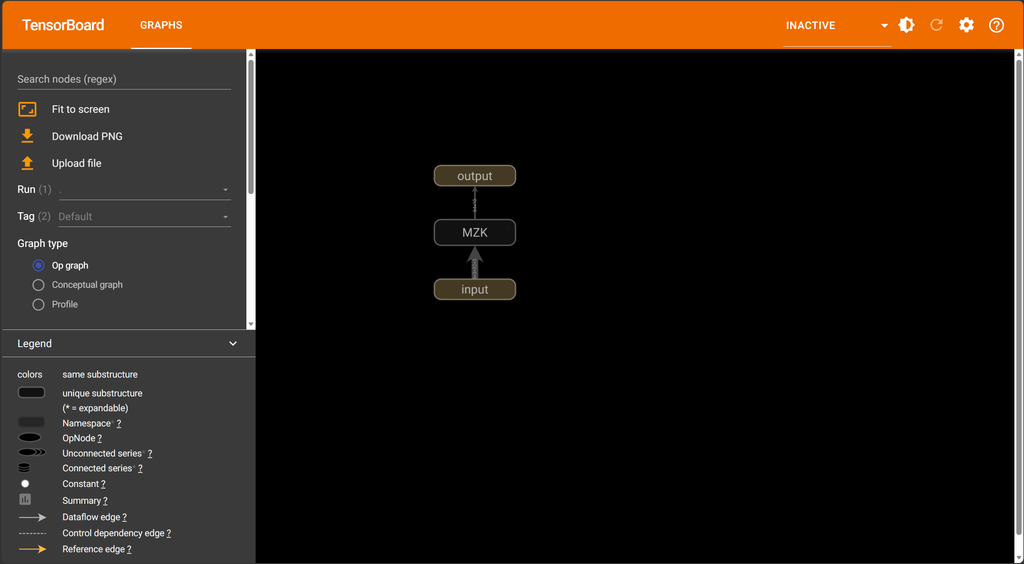
我们可以双击其中的方框进行查看更细致的结构,例如这里我双击网络模型MZK
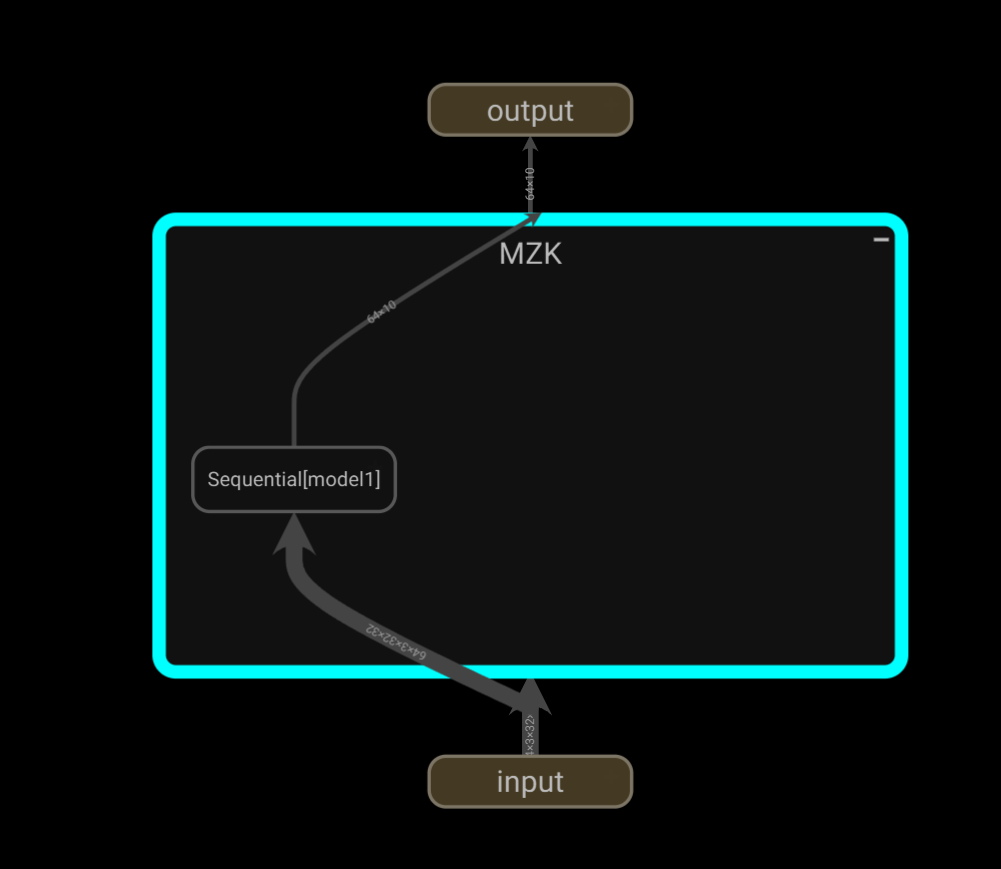
可以得到它的运行过程,再双击一次可以得到具体的网络框架:
总结
这就是关于 Pytorch 神经网络需要学习的所有基础知识了,可以帮助我们更好的学习和观看其他网络模型的代码
另外,这里给出关于 CIFAR10数据集的下载链接,因为官方下载很慢:
评论(0)
暂无评论