

引言
这一篇文章继续讲解关于Pytroch的基本函数
一. Transforms
- 1.1 导入
这里是导入transforms的代码
from torchvision import transforms- 1.2 结构
transforms相当于一个工具箱,对图片进行一系列的操作,然后得到想要的图片形式,如图
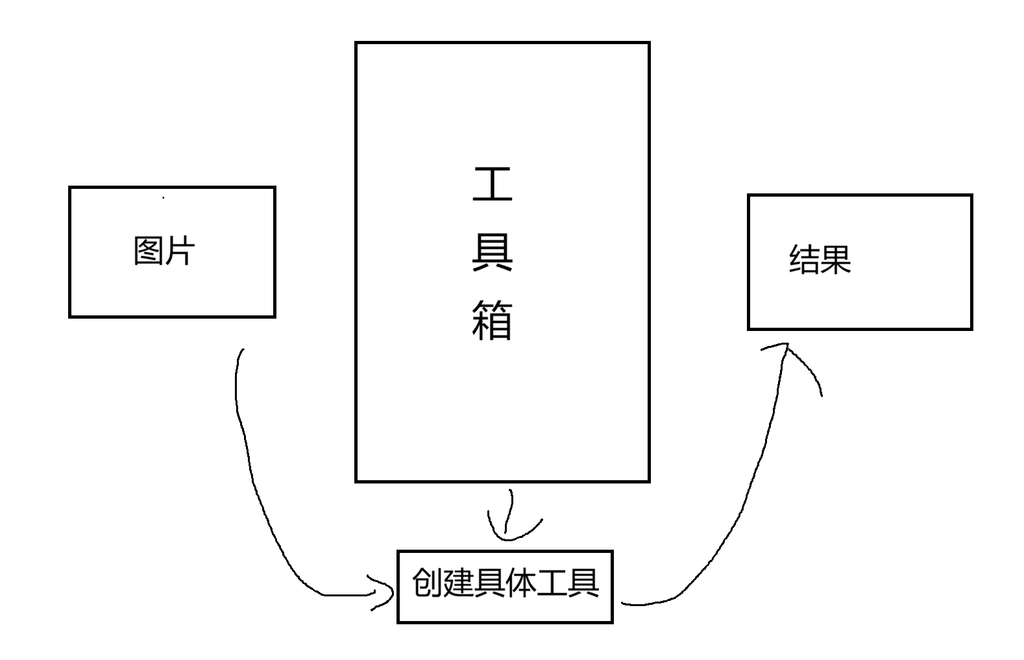
- 1.3 如何使用
这里拿 transforms.ToTensor 举例,要先创建一个类对象,再利用这个类对象对图片(img)进行操作,代码如下
tensor_test = transforms.ToTensor()
tensor_img = tensor_test(img)
#这样就可以将img从PIL类型转化为Tensor类型- 1.4 常见的transforms函数
a. Totensor
作用是将类型转化为Tensor类型
创建对象时不需要参数,使用时参数为要转化类型的对象
使用方法如上
b. Normalize
作用是将图片标准化,创建对象时参数为标准化的平均值和标准差,是为了使模型更适合训练,而不是给人看的
参数第一个代表平均值,第二个代表标准差
使用例子如下:
#标准化练习
img_path1 = "D:\\pytorch练习\\Transforms练习\\图片\\4b87d95598a89b0eab64d687911b1ce4_720.jpg"
img1 = Image.open(img_path1)
img1 = tensor_test(img1)
normalizer = transforms.Normalize([0.485, 0.456, 0.406],[0.229, 0.224, 0.225])
writer.add_image("mzk1", normalizer(img1), 0)
这是这张图片标准化前后的区别(右为原图):
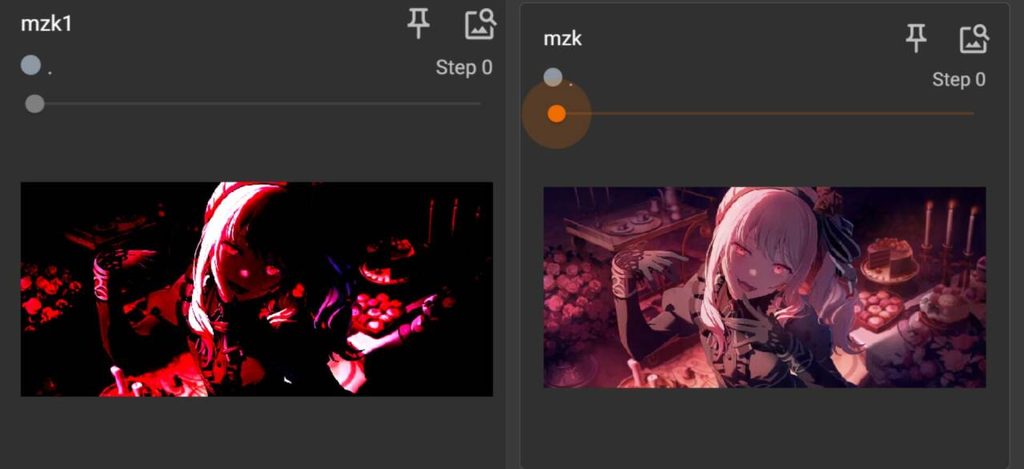
c. Resize
作用是改变图片尺寸,拉缩图片,在之后的Dataloader中很有用
参数是图片的大小,两个参数代表长宽,一个参数代表等比例缩放,使用例子如下
#resize练习
Resize_test = transforms.Resize((256, 256))
print(img1.shape)
img2 = Resize_test(img1)
print(img2.shape)
writer.add_image("mzk2", img2, 1)
对比图如下(右为原图):
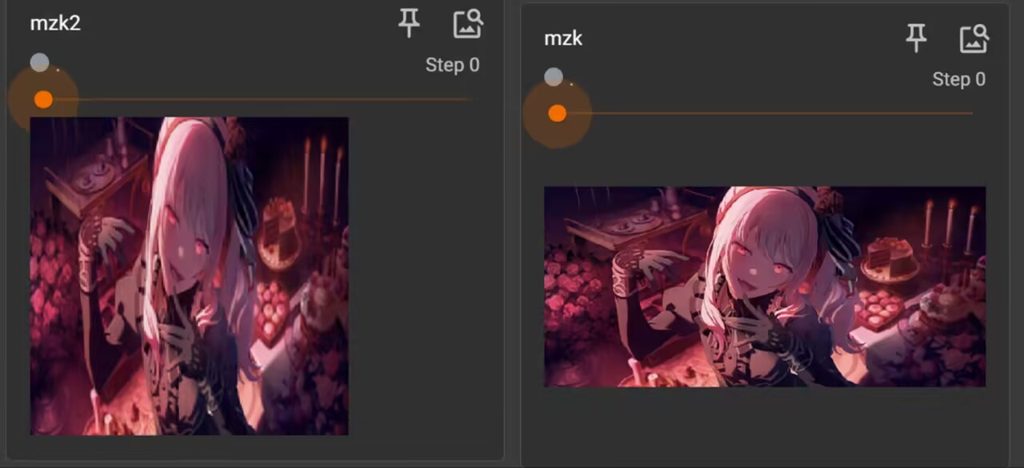
d. RandomCrop
作用是随机裁剪
参数与Resize类似,代表随机裁剪的尺寸
这里给出例子:
#randomcrop练习
Randomcrop_test = transforms.RandomCrop((128,128))
for i in range(len(img_paths)):
    img_path = os.path.join(path, img_paths[i])
    img = Image.open(img_path)
    img = tensor_test(img)
    img = Randomcrop_test(img)
    writer.add_image("mzk3", img, i)
这里是对一个文件中的图片进行随机裁剪
e. Compose
作用是将各种transforms参数组合起来,一次性对图片使用,可以减少代码的冗杂度
参数就是各种transforms参数,用[]括起来
transform_set = torchvision.transforms.Compose([torchvision.transforms.Resize([256, 256]), torchvision.transforms.ToTensor()])这里的作用就是先将图片Resize后再转化为Tensor类型
- 1.5 总结使用方法
a. 先创建一个合适的对象
b. 将目标图片代入作为参数,得到结果
二. torchvision中数据集的使用
- 2.1 如何下载数据集
a. 通过官方下载渠道下载数据集
这里给出一个例子,再结合例子讲解
test_data = torchvision.datasets.CIFAR10("./dataset", train=False, transform=torchvision.transforms.ToTensor())第一个参数是下载到哪里,第二个参数表示下载的是训练集还是测试集,第三个参数表示对数据集进行transform的一系列操作
b. 直接读取本地数据集
dataset = torchvision.datasets.ImageFolder(root = "data/val", transform = transform_set)这里将CIFAR10改为了ImageFolder,因为我这里下载的本地数据集是img类型的图片
而本地数据集不能通过编译器分辨训练集和测试集,因此不写
- 2.2 如何使用
首先我们可以通过索引观看内容
print(dataset[0])得到结果如图,前面的数组表示图片数据,后面的 0 表示图片标签
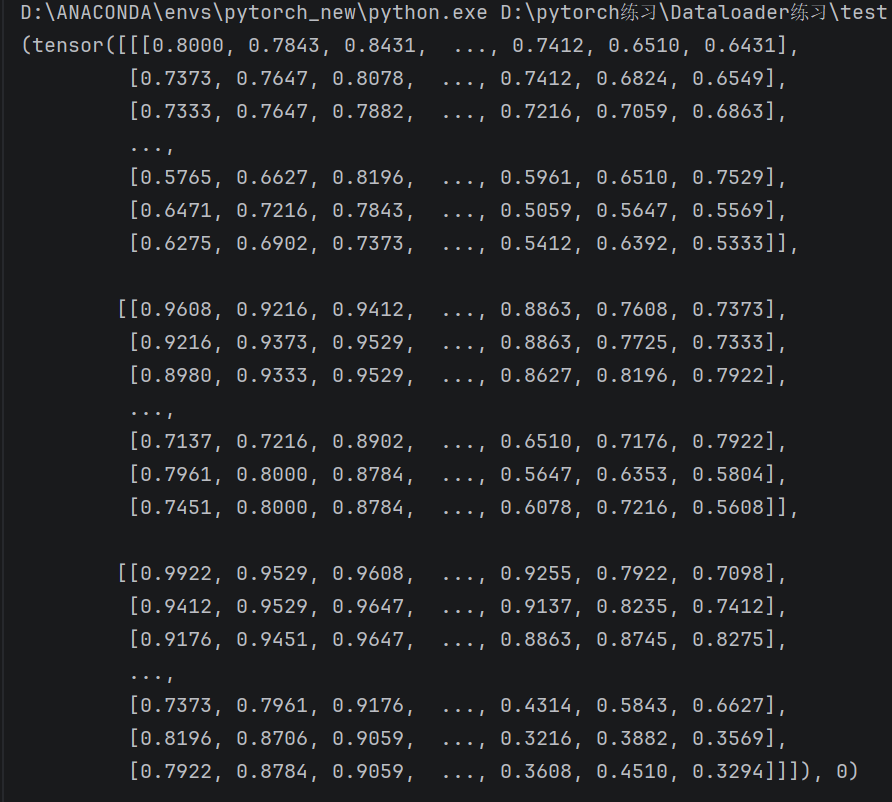
我们也可以通过循环将前十张图片写进tensorboard
for i in range(10):
    img, label = dataset[i]
    writer.add_image("test" , img, i)
利用 classes + [label] 可以看具体标签
img, label = dataset[0]
print(dataset.classes[label])
结果如下:

因为这里我的图片类型是ants,所以输出ants
三. Dataloader的使用
- 3.1 作用
决定如何使用数据集
- 3.2 参数
a. 第一个参数为自定义的数据集datatset
b. batch_size:决定每次使用数据集中的几个数据(前提是图片尺寸要相同)
c. shuffle:每次使用时是否要打乱数据顺序,默认为False
d. num_workers:加载时采用多进程还是单进程,默认为0
e. drop_last:最后余下的数据是否要舍去
这里给出一个例子:
transform_set = torchvision.transforms.Compose([torchvision.transforms.Resize([256, 256]), torchvision.transforms.ToTensor()])

test_dataloader = torch.utils.data.DataLoader(dataset = dataset, batch_size = 64, shuffle = True, drop_last = False, num_workers=0)
注意这里我将所有的图片进行了统一的Resize,否则无法使用DataLoader
- 3.3 使用
a. 准备一个数据集(注意将数据对象的大小统一)
transform_set = torchvision.transforms.Compose([torchvision.transforms.Resize([256, 256]), torchvision.transforms.ToTensor()])b. 导入并且创建一个DataLoader对象
test_dataloader = torch.utils.data.DataLoader(dataset = dataset, batch_size = 64, shuffle = True, drop_last = False, num_workers=0)c. 读取数据
因为DataLoader返回的是一个数据包,所以我们接受到的也是一个数据包,进行接受时得到的就是imgs和labels
imgs和labels都是一个数据集,因此进行tensorboard写入时要使用add_images
for epoch in range(2):
    step = 0
    for data in test_dataloader:
        imgs, labels = data
        writer.add_images(f"epoch: {epoch}" , imgs, step)
        step += 1
得到的结果如下:
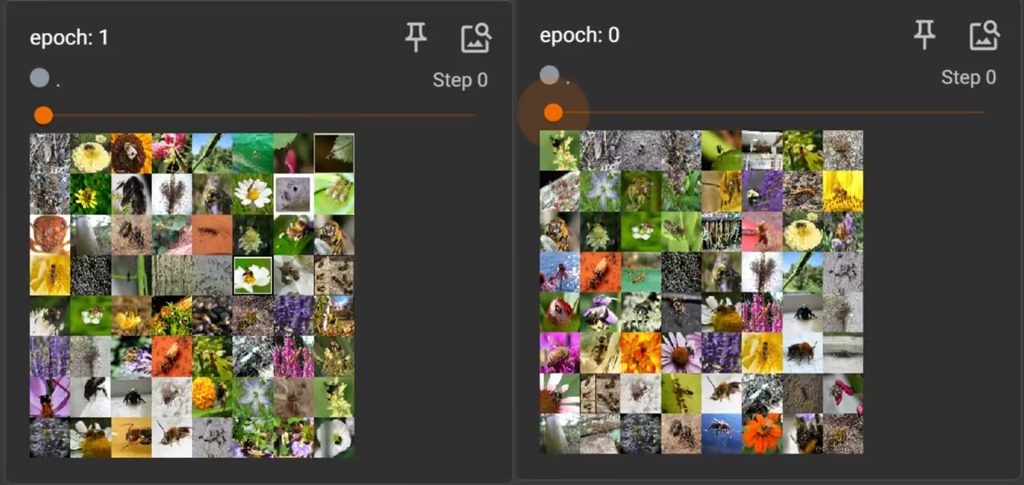
因为shuffle填的True,因此图片顺序会不同
总结
Pytorch的基本函数介绍就到这里结束了,下一章将讲解关于神经网络的知识
还有两个周就可以去确定研究方向了,加油加油
评论(0)
暂无评论