

引言
在上一篇博客中我们学习了VAE的相关知识,VAE虽然在生成速度上有显著提升,但它毕竟是比较老的模型,单靠VAE生成出的图片效果其实较为模糊,那有没有一种生成模型可以生成出更清晰更接近真实的图片,这就是本篇文章要介绍的内容:GAN
一. 目标
再生成的过程中,我们有这样一个问题:
希望从训练样本分布中采样新数据,但这个分布不仅维度高而且还很复杂,难以直接实现
我们的解决方案是这样的:
对一个简单的分布采样,比如均匀分布;然后,学习一种映射将其变换到训练样本分布
这里就引出了另一个问题:
我们该如何实现这个映射呢,答案就是通过神经网络
二. 原理
于是,伊恩·古德费洛(Ian Goodfellow)想出来了一种模型,就是通过对抗训练来训练模型,具体是什么意思呢
这里我们要建立两个网络:
生成网络: 期望能够产生尽量真实的图片,进而骗过判别器
判别网络: 期望能够准确的区分真假图片
原理:
利用判别器判断生成网络生成的图片是否真实,在这个过程中通过反向传播不断更新判别网络的参数,进而可以更好的判断图片的真实性
而生成网络为了骗过判别器,也要不断的通过反向传播更新生成网络的参数,从而生成更真实的图片
可以总结为这样的图表:
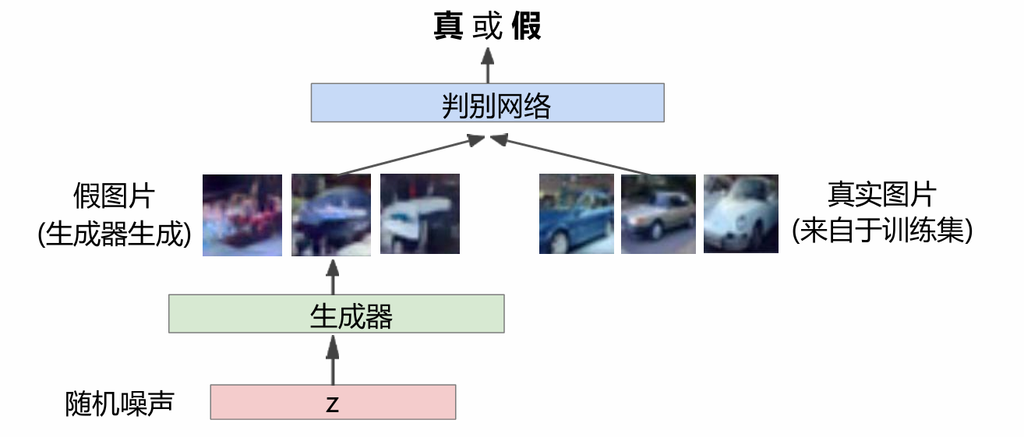
因此,我们也可以将 GAN 理解为两个玩家的游戏
三. 公式
- 1. 总公式
采用 minimax 的方式联合训练
minimax 的公式如下:
minGmaxDV(G,D)= Ex∼pdata[logD(x)]+ Ez∼pz[log(1−D(G(z)))]
单看这个公式肯定是无法理解的,接下来我将剖析进行讲解
- 2. 参数
首先我们要知道判别器判别真实图片输出的值在 0 – 1 之间
D(x):判别器判别真实标本的概率
G(z):生成器输出的图片
D(G(z)):判别器判别假标本的概率
理解了参数后,我们就可以开始理解什么是 minimax 了
- 3. 如何训练
minimax 顾名思义就是要求最大和最小
求最大时:此时是为了使判别器变强,使D(x)接近1,使D(G(z))接近0
求最小时:此时是为了使生成器变强,D(x)不变,使D(G(z))接近1
四. 训练顺序
一般是先训练判别器,再训练生成器
因为判别器太弱无法支撑生成器的训练,而判别器第一次可以直接通过真实样本进行训练
然后再不断交替完成这两个训练
五. 其他问题
因为直接优化生成器难用,因此刚开始时 D(G(z)) 都接近0,导致 1−D(G(z)) = 1
因此反向传播返回的梯度就就小,更新的参数变化就小
所以我们需要将问题转化为:求 log(D(G(z))) 的最大值
这样可以使刚开始时的梯度更大,训练更快,而且意义是相同的
六. 训练结果
当生成器可以使判别器基本无法判别真实和生成图片时就可以停止训练了,虽然大多时候也不能完成
最后我们去掉判别器,保留得到生成器就可以了
这里给出训练的流程演示视频:
总结
这只是GAN的训练原理,关于它的数学原理这里并没有讲解,以后如果有机会再说吧
评论(0)
暂无评论